Tecnologia Científica
Como prever o comportamento de moléculas a partir de dados escassos
Uma abordagem de aprendizado de máquina chamada CheMeleon oferece uma maneira prática de desenvolver novos medicamentos ou outras moléculas com experimentação muito menos detalhada e dispendiosa.
Por
David L. Chandler - 09/11/2026

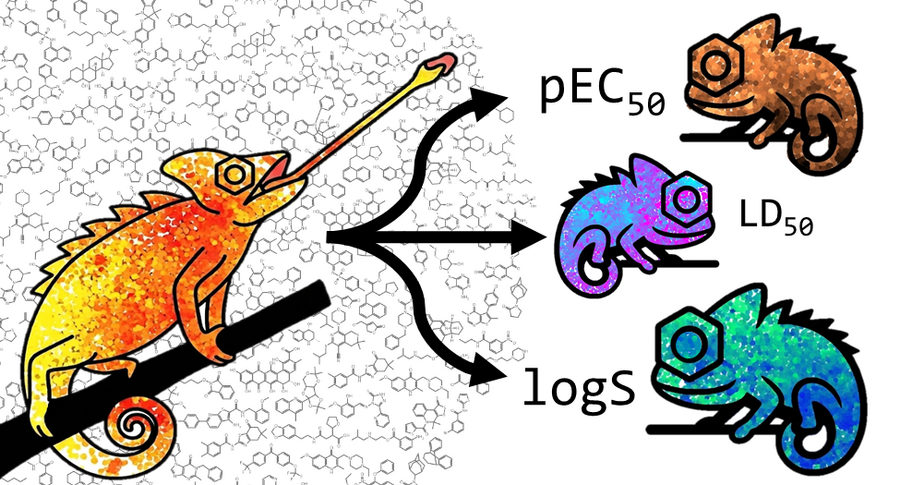
Como um camaleão que muda de cor, o CheMeleon adapta um único modelo pré-treinado para prever diversas propriedades moleculares, como potência (pEC50), toxicidade (LD50) e solubilidade (logS). O modelo, desenvolvido pelo MIT, primeiro aprende química prevendo descritores moleculares fáceis de calcular para cerca de um milhão de moléculas e, em seguida, ajusta-se a cada nova tarefa. Créditos: Imagem cedida pelos pesquisadores.
A descoberta de novas moléculas para usos específicos é um dos principais motores do progresso em uma ampla variedade de indústrias, sejam empresas farmacêuticas em busca de novos medicamentos ou empresas de eletrônica ou energia que procuram novos materiais com propriedades particulares. Mas também é, em grande parte, um processo de tentativa e erro, porque ainda não existe uma maneira de prever com perfeição como um determinado composto químico se comportará em termos da miríade de propriedades e respostas diferentes que os materiais podem apresentar.
Avanços recentes foram feitos no uso de inteligência artificial e aprendizado de máquina para complementar ou acelerar cálculos trabalhosos baseados em princípios físicos, que podem ao menos fornecer alguma orientação inicial sobre quais compostos podem valer a pena sintetizar e testar. Agora, um novo método desenvolvido no MIT mostra que, quando há poucos dados sobre alguma propriedade tecnologicamente relevante, como as afinidades de ligantes para um alvo celular recém-descoberto para um potencial medicamento, essa abordagem pode superar outros métodos existentes para reduzir o número de moléculas possíveis que podem valer a pena investigar.
Os resultados foram divulgados na edição de 14 de setembro do Journal of Chemical Information and Modeling , em um artigo de autoria do estudante de pós-graduação do MIT Akshat Shirish Zalte e do recém-formado Jackson Burns PhD '26, do pesquisador científico Charles Abreu, do professor William Green e de três pesquisadores da empresa química BASF.
Uma versão anterior do artigo está disponível online desde o ano passado, e o modelo de código aberto desenvolvido pela equipe, chamado CheMeleon, já é utilizado regularmente por diversas empresas farmacêuticas. O CheMeleon foi construído utilizando o ChemProp, um pacote de aprendizado de máquina de código aberto também desenvolvido e mantido pelo grupo Green no MIT, e qualquer pessoa pode baixar o CheMeleon através do ChemProp e ajustá-lo para seus próprios fins.
No início deste ano, houve um concurso organizado pela OpenADMET para tentar prever as propriedades de uma variedade de novas moléculas que não haviam sido sintetizadas anteriormente, diz Green, professor titular da Cátedra Hoyt Hottel de Engenharia Química. "Foi um grande concurso, com muita participação", afirma. Quando os vencedores foram anunciados, descobriu-se que nove dos 20 melhores trabalhos haviam utilizado o CheMeleon em seus processos. "Então começamos a receber todos os tipos de consultas de empresas farmacêuticas sobre isso, mas nosso artigo tinha acabado de ser submetido; ainda nem havia sido revisado por pares."
Enquanto o artigo passava pelo processo de revisão, sua influência já se espalhava. Pelo menos uma empresa farmacêutica, diz Green, "enviou uma mensagem a todos os seus funcionários, dizendo: 'Sempre que estiverem modelando uma propriedade, comecem com o CheMeleon, essa é a nossa nova política da empresa'", ao tomarem as decisões iniciais sobre quais moléculas priorizar.
A chave do CheMeleon foi o pré-treinamento de um modelo de aprendizado de máquina com dados detalhados sobre um milhão de moléculas diferentes, permitindo que ele aprendesse correlações entre a estrutura de uma determinada molécula e seu comportamento em relação a um catálogo de cerca de 1.600 descritores desenvolvidos por químicos ao longo de décadas. O CheMeleon pode então ser ajustado para prever propriedades bem conhecidas, como solubilidade e viscosidade, até propriedades mais esotéricas, como bioatividade ou reatividade com uma determinada proteína ou enzima.
Essas milhões de moléculas representam uma fração minúscula das inúmeras maneiras pelas quais os átomos podem se ligar, mas fornecem exemplos suficientes para que, uma vez treinado com elas, o sistema de IA possa descobrir por si só muitos padrões e relações subjacentes e, em seguida, aplicá-los a uma nova molécula desconhecida que lhe for apresentada.
“A maioria dos modelos de aprendizado profundo atuais requer mais dados do que os métodos tradicionais”, diz Zalte. Alguns modelos bem-sucedidos utilizam dados extensivos da literatura publicada em periódicos de química, afirma ele. “Nós não consultamos a literatura. Simplesmente calculamos uma série de descritores moleculares, como peso molecular ou número de oxigênios, entre outros.” A previsão desses descritores, então, forma a base para sua tarefa de pré-treinamento.
CheMeleon é um modelo básico pré-treinado. Inspirado em modelos básicos de linguagem bem conhecidos, como ChatGPT e Claide, que são essencialmente desenvolvidos alimentando-os com grandes quantidades de informações da internet, o CheMeleon usa descritores moleculares de um milhão de moléculas do PubChem, um grande banco de dados de informações químicas de acesso livre mantido pelos Institutos Nacionais de Saúde dos EUA.
Por outro lado, com os modelos clássicos baseados em conhecimento especializado, os especialistas em uma área inserem manualmente informações detalhadas sobre o assunto. No desenvolvimento desses modelos clássicos, explica ele, por exemplo, sabe-se por meio de experimentos que uma determinada propriedade de interesse, como a solubilidade, pode estar relacionada a descritores específicos das mesmas moléculas, “como o peso molecular, o número de oxigênios presentes ou o quão ramificada ou volumosa a molécula é”.
Com a abordagem desta equipe, eles podem começar com uma arquitetura de rede neural existente e treiná-la para aprender os princípios subjacentes. "Não estamos treinando para uma propriedade específica, mas como um modelo geral que entende algum nível de química, de modo que, mesmo que você o ajuste com apenas alguns pontos de dados para a tarefa que lhe interessa, ainda poderá obter um bom desempenho", diz ele. Isso se deve ao fato de o modelo "não precisar aprender tudo do zero".
Para verificar sua utilidade, “Comparamos nosso modelo não apenas com outros modelos básicos existentes, mas também com modelos clássicos que utilizam princípios desenvolvidos por especialistas”, diz Zalte. Comparando seu desempenho em 58 casos de teste, “vemos que nosso modelo se destaca”.
Green acrescenta: "O modelo fundamental do CheMeleon reduz drasticamente o número de moléculas que precisam ser testadas experimentalmente para prever com precisão as propriedades de novas moléculas. Esta é uma enorme vantagem, visto que sintetizar e testar um grande número de moléculas é um processo lento e dispendioso."
Além dos membros do MIT, a equipe também incluiu Jochen Sieg, Christian Feldmann e Miriam Mathea, pesquisadores da BASF SE, na Alemanha. O trabalho foi financiado pelo consórcio Machine Learning for Pharmaceutical Discovery and Synthesis, juntamente com bolsas de pesquisa do Departamento de Energia dos EUA e da MathWorks.